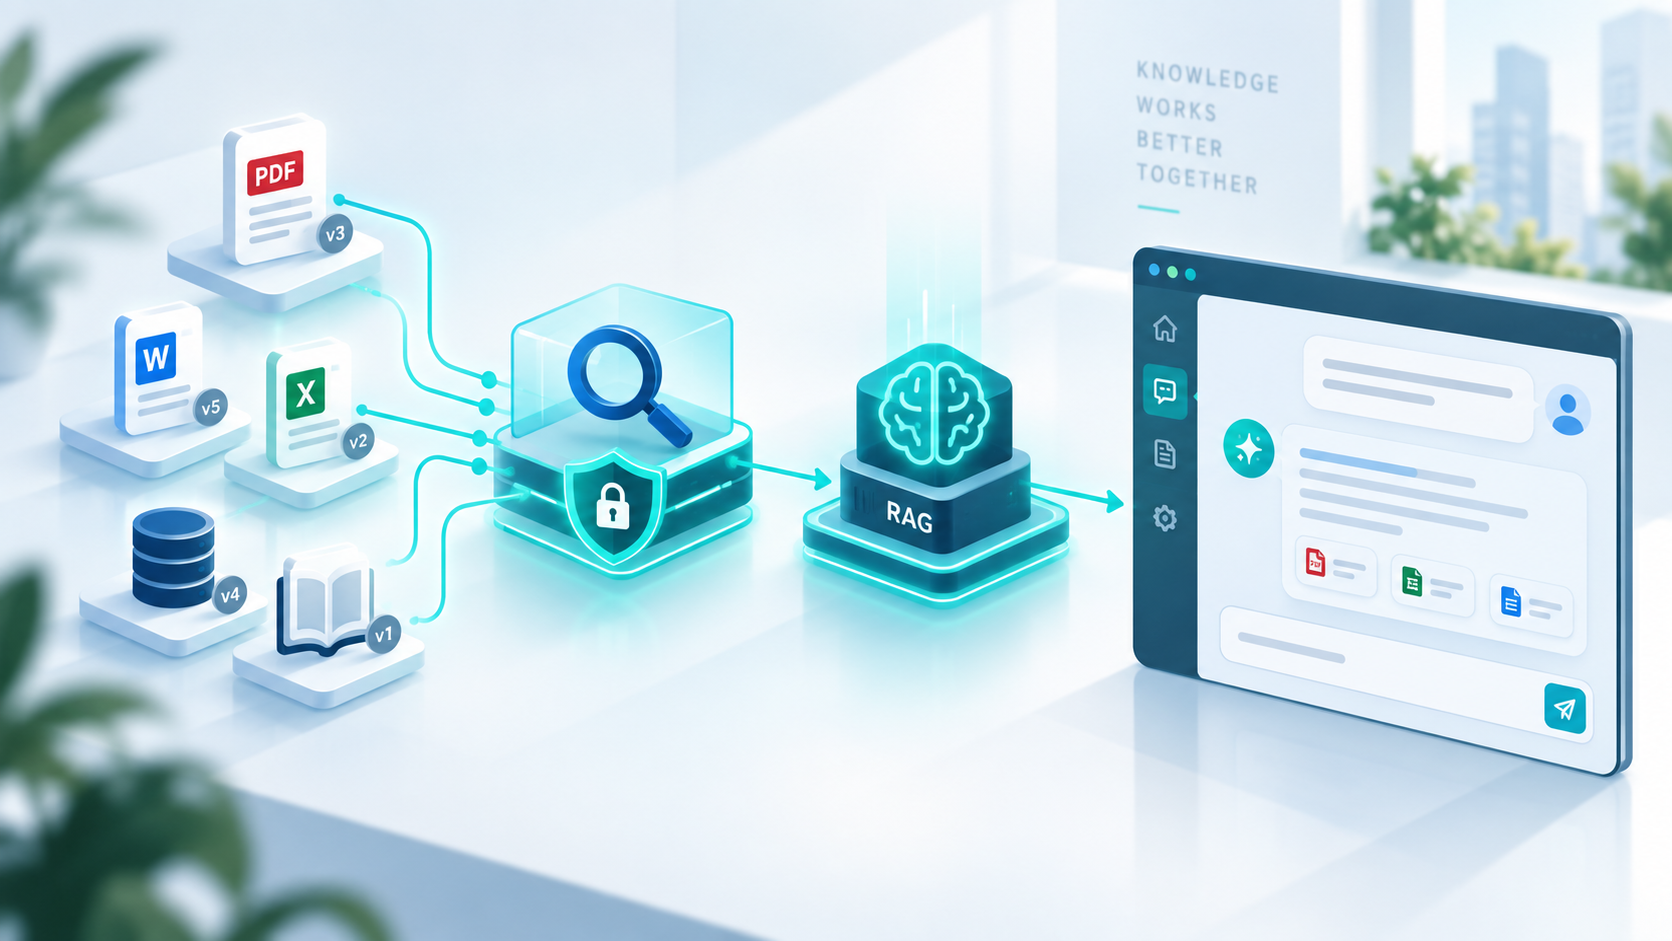
Doanh nghiệp thường nghĩ chỉ cần đưa tài liệu nội bộ vào AI là đã có trợ lý tri thức. Thực tế, hệ RAG phụ thuộc nguồn dữ liệu, quyền truy cập, cách truy xuất, đánh giá và trách nhiệm kiểm chứng.
Trả lời nhanh
RAG giúp AI tìm dữ liệu liên quan từ nguồn kiến thức của doanh nghiệp rồi dùng dữ liệu đó làm ngữ cảnh để tạo câu trả lời. Một hệ RAG tốt cần tài liệu đáng tin, metadata rõ, quyền truy cập phù hợp, retrieval chính xác và cơ chế đánh giá để biết khi nào câu trả lời chưa đủ cơ sở.
Một trong những demo AI dễ gây ấn tượng nhất hiện nay là đưa vài file PDF vào hệ thống rồi bắt đầu hỏi. Chính sách công ty là gì, quy trình mua hàng ra sao, sản phẩm có thông số nào? Chỉ vài giây sau, AI trả lời khá trôi chảy.
Ở mức prototype, trải nghiệm đó rất thuyết phục. Nhưng khi sử dụng thật, câu hỏi đổi khác: nếu có ba phiên bản quy trình thì AI lấy bản nào? Nhân viên Sales có được hỏi dữ liệu Finance không? Nếu không tìm thấy tài liệu phù hợp, hệ thống nên trả lời thế nào? Đây là lúc bài toán RAG cho doanh nghiệp thực sự bắt đầu.
RAG cho doanh nghiệp thực chất giải quyết vấn đề gì?
LLM không tự biết quy trình nội bộ vừa cập nhật, chính sách riêng hay tài liệu kỹ thuật chỉ tồn tại trong doanh nghiệp. Retrieval Augmented Generation tách việc tìm thông tin khỏi việc sinh câu trả lời: hệ thống tìm phần dữ liệu liên quan, đưa nó vào context rồi mới yêu cầu mô hình trả lời.
Câu hỏi → Retrieve dữ liệu → Augment context → Generate câu trả lời → Kiểm chứng
RAG không phải huấn luyện lại toàn bộ model mỗi khi tài liệu thay đổi. Vì vậy nó phù hợp với knowledge base, quy trình nghiệp vụ và tài liệu kỹ thuật. Để hiểu lớp dữ liệu phía sau, có thể xem thêm 50 khái niệm Data nền tảng, Vector Database và Data Agent.
Vì sao “nạp PDF vào AI” chưa phải một hệ RAG tốt?
Nhiều phiên bản cùng tồn tại
Nếu quy trình năm 2024, bản sửa 2025 và bản được duyệt năm 2026 cùng được index nhưng thiếu ngày hiệu lực hoặc trạng thái, retrieval có thể lấy đúng nội dung từ một tài liệu đã hết hiệu lực. Đây không hẳn là hallucination; đó là lỗi quản trị nguồn.
Chất lượng tài liệu không đồng đều
Quy trình chính thức, biên bản họp, bản nháp và tài liệu đào tạo cũ không nên được xếp ngang nhau. Hệ thống cần biết nguồn nào là chuẩn, ai chịu trách nhiệm và khi nào tài liệu có hiệu lực.
Không phải nội dung nào cũng dễ truy xuất
Bảng biểu, sơ đồ, header lặp lại và nội dung bị chia giữa nhiều trang có thể làm chunking mất ngữ cảnh. Một câu hỏi cần kết hợp điều kiện ở trang 3 với ngoại lệ ở trang 12 sẽ thất bại nếu retrieval chỉ lấy được một phía.
RAG không biến tài liệu lộn xộn thành tri thức sạch. Nó thường làm lộ rõ chất lượng quản trị tài liệu mà doanh nghiệp vốn đã có.
Retrieval là lớp cần kiểm tra trước khi đổi model
Khi AI trả lời sai, phản xạ thường là sửa prompt hoặc đổi model. Với RAG, câu hỏi đầu tiên nên là: hệ thống đã lấy đúng context chưa? Context sai khiến model mạnh cũng khó trả lời đúng; context đúng giúp một model vừa phải vẫn tạo ra kết quả tốt.
| Nhóm lỗi | Biểu hiện | Nơi cần kiểm tra |
|---|---|---|
| Retrieval | Không lấy đúng tài liệu hoặc thiếu context | Chunking, embedding, metadata, query, ranking |
| Generation | Context đúng nhưng diễn giải sai | Prompt, model, instruction, output control |
Metadata và quyền truy cập quan trọng không kém embedding
Tài liệu nên có phòng ban, loại tài liệu, ngày hiệu lực, trạng thái, phiên bản, sản phẩm, chi nhánh và nhóm người được sử dụng. Semantic search tìm nội dung gần với câu hỏi; metadata bảo đảm nội dung đó còn đúng trong bối cảnh doanh nghiệp.
Màn hình đăng nhập chatbot không đồng nghĩa dữ liệu phía sau đã được phân quyền đúng. Hệ thống phải chặn tài liệu không được phép ngay ở lớp retrieval, thay vì đưa dữ liệu bí mật vào context rồi hy vọng model không tiết lộ.
Khi AI chuyển từ công cụ cá nhân sang hệ thống doanh nghiệp, giới hạn dữ liệu trở nên đặc biệt quan trọng. Bài AI thay đổi cách một cá nhân làm việc cung cấp thêm góc nhìn thực tế này.
Đừng chỉ test bằng những câu hỏi có câu trả lời đẹp
Nên bắt đầu từ một domain hẹp: hướng dẫn SAP Business One, quy trình mua hàng hoặc tài liệu kỹ thuật của một nhóm sản phẩm. Phạm vi hẹp giúp xác định owner, bộ câu hỏi chuẩn và tiêu chí chấp nhận.
- Câu hỏi có đáp án rõ trong tài liệu chính thức.
- Câu hỏi cần tổng hợp từ nhiều đoạn.
- Câu hỏi dùng từ đồng nghĩa với tài liệu.
- Câu hỏi có tài liệu cũ và mới cùng tồn tại.
- Câu hỏi mà người dùng không có quyền xem nguồn.
- Câu hỏi không có đủ dữ liệu để trả lời.
- Câu hỏi có giả định sai và cần hệ thống từ chối.
Một trợ lý đáng tin không phải hệ thống luôn trả lời. Có lúc câu đúng nhất phải là: “Tôi chưa tìm thấy nguồn đủ tin cậy để kết luận”. Tư duy kiểm thử này cũng được phân tích trong bài AI trong kiểm thử phần mềm.
Citation cần được thiết kế từ đầu
Người dùng phải biết câu trả lời dựa trên chính sách nào, phiên bản nào hoặc đoạn nào. Điều này đặc biệt quan trọng với ERP, tài chính, nhân sự và pháp lý. Một hệ thống hỗ trợ công việc phải trả lời được cả câu “Dựa trên đâu?”.
RAG cũng không thay thế người hiểu nghiệp vụ. AI càng mạnh, giá trị của người hiểu process, dữ liệu và bối cảnh càng rõ; xem thêm lập trình viên thời AI: khi code không còn là lợi thế duy nhất.
Một kiến trúc RAG tối thiểu gồm những lớp nào?
- Knowledge Sources: nguồn chính thức và owner.
- Ingestion: đọc, làm sạch, chia tài liệu và gắn metadata.
- Index/Retrieval: tìm đúng nội dung liên quan.
- Access Control: giới hạn dữ liệu theo quyền.
- Generation: dùng context và không tự suy diễn ngoài nguồn.
- Evaluation: bộ câu hỏi chuẩn để đo retrieval và câu trả lời.
- Monitoring: ghi nhận câu hỏi thất bại và phản hồi người dùng.
Checklist trước khi đưa RAG vào nội bộ
- Bài toán và phạm vi đã đủ rõ chưa?
- Nguồn nào được xem là chính thức và ai là owner?
- Có version, ngày hiệu lực và trạng thái không?
- Dữ liệu nhạy cảm đã được phân loại chưa?
- Quyền người dùng được áp dụng từ retrieval chưa?
- Chunking có giữ đủ ngữ cảnh không?
- Có benchmark trước khi đổi model hoặc cấu hình không?
- Hệ thống biết từ chối khi thiếu nguồn không?
- Câu trả lời có thể truy về tài liệu gốc không?
- Có ghi nhận feedback và câu hỏi thất bại không?
Câu hỏi thường gặp
RAG khác gì với upload file vào chatbot AI?
Upload file phù hợp nhu cầu cá nhân hoặc phạm vi nhỏ. RAG ở mức hệ thống có knowledge source, index, retrieval, metadata, quyền truy cập, đánh giá và vận hành cho nhiều người dùng.
RAG có giúp AI hết hallucination không?
Không. RAG có thể giảm lỗi do thiếu context nhưng vẫn có thể retrieve sai hoặc diễn giải sai. Cần đánh giá riêng retrieval và generation.
Có bắt buộc dùng Vector Database không?
Không. Retrieval có thể kết hợp keyword search, vector search, hybrid search và metadata filtering tùy bài toán.
Doanh nghiệp nhỏ có cần RAG không?
Có thể, nếu có lượng kiến thức nội bộ đủ lớn và nhu cầu tra cứu lặp lại rõ. Nên bắt đầu bằng một domain hẹp thay vì chatbot toàn doanh nghiệp.
Dữ liệu ERP có thể đưa vào RAG không?
Có, nhưng cần phân biệt tài liệu với dữ liệu giao dịch có cấu trúc. RAG phù hợp policy và hướng dẫn; câu hỏi số liệu thường cần query có kiểm soát hoặc Data Agent.
Kết luận
RAG cho doanh nghiệp không khó ở việc làm chatbot trả lời vài câu từ PDF. Phần khó là biến nó thành hệ thống đủ đáng tin để dùng hằng ngày. Hãy bắt đầu từ domain nhỏ, nguồn có owner, phiên bản và quyền truy cập rõ; sau đó mới tối ưu chunking, retrieval, prompt và model.